AI가 학습한다는 건, 정말 무슨 뜻일까?
"AI가 학습했다"라는 말을 자주 듣습니다.
뉴스에서도, 광고에서도 이 표현은 너무 자연스럽게 쓰입니다. 그런데 이 말을 그대로 받아들여도 괜찮을지 한 번쯤은 의심해볼 필요가 있습니다.
AI의 학습은 우리가 떠올리는 '공부'와 같은 의미일까요?
아이가 고양이를 배우는 방식
아이에게 고양이를 가르친다고 가정해봅시다. 처음에는 고양이와 비슷하게 생긴 동물까지 고양이라고 부를 수 있습니다. 어른이 차이를 알려주고, 여러 동물을 직접 보면서 아이는 점점 구별하는 법을 배웁니다. 어느 순간부터는 처음 보는 고양이도 알아봅니다.
이게 우리가 '학습'이라는 단어를 들을 때 자연스럽게 떠올리는 장면입니다.
AI의 학습도 겉으로 보면 비슷합니다. 고양이 사진을 수 많이 보여주고, AI가 예측한 결과를 정답과 비교하고, 틀리면 조정하고 다시 시도합니다. 표면만 보면 분명 닮아 있습니다.
AI는 무엇을 바꾸며 학습할까
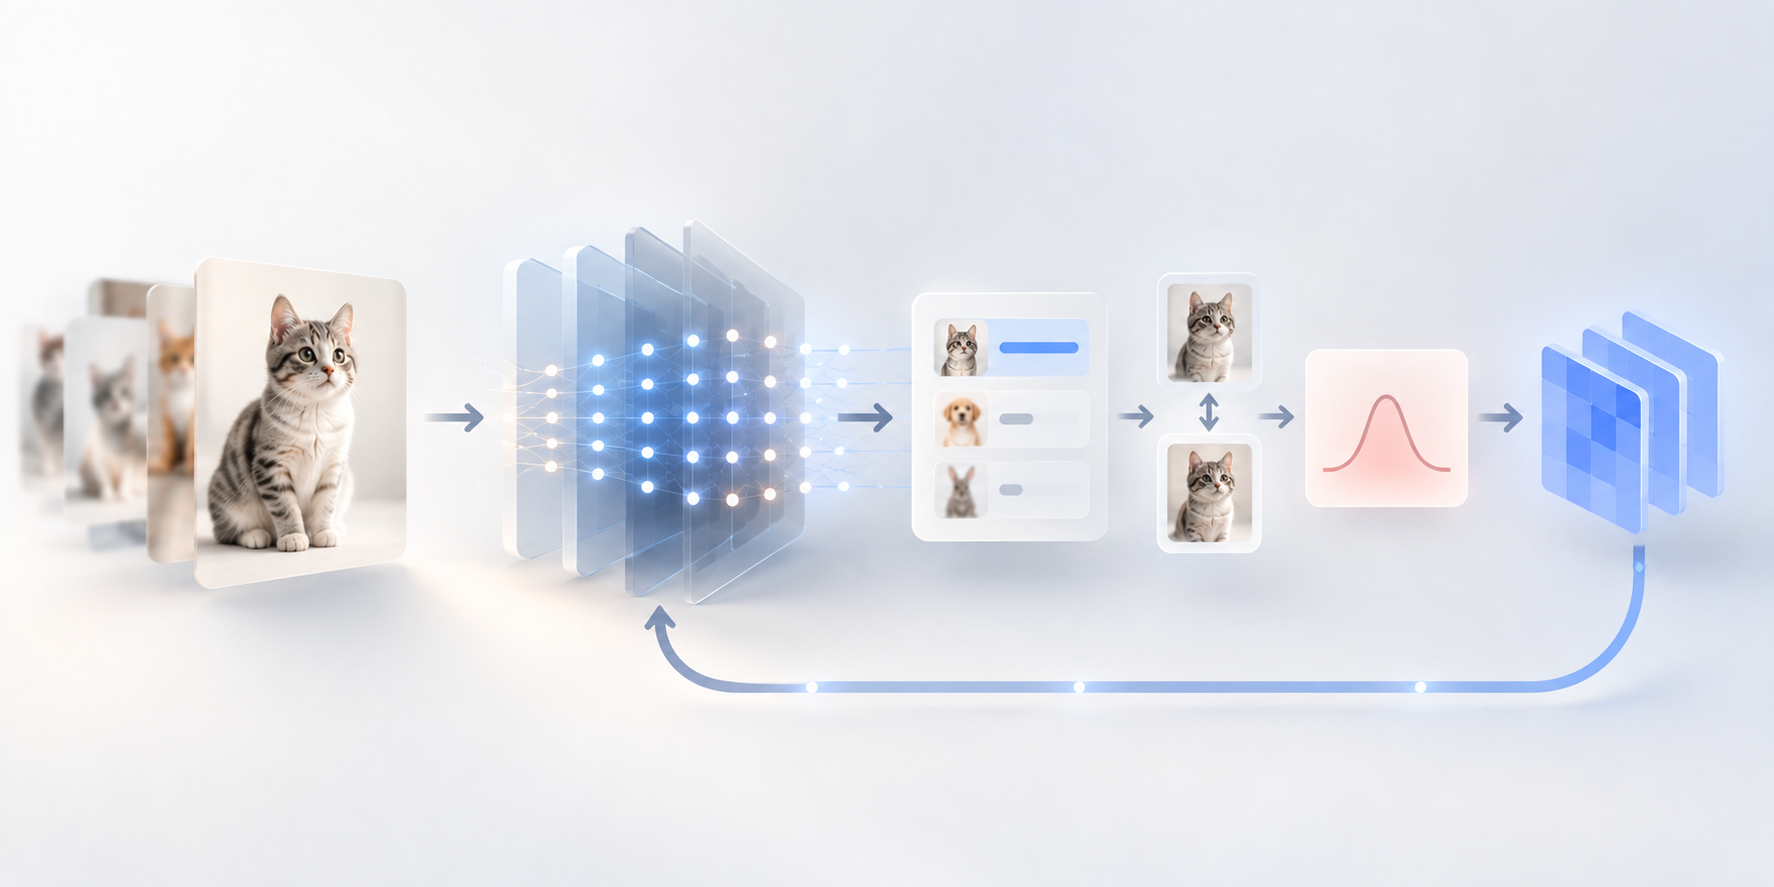
하지만 내부에서 일어나는 일은 다릅니다. AI는 학습 과정에서 이전 글에서 이야기했던 파라미터, 즉 모델을 구성하는 수많은 숫자를 조정합니다. 예측이 정답과 얼마나 다른지 계산하고 그 오차를 줄이는 방향으로 숫자들을 조금씩 바꿔가는 겁니다.
이때 오차가 각 파라미터에 얼마나 영향을 받는지 계산하는 방법이 역전파(Backpropagation)입니다. 그렇게 구한 정보를 바탕으로 파라미터를 조정하고, 다시 예측하는 과정을 반복합니다. 복잡해 보이지만 핵심은 분명합니다. 예측과 정답 사이의 오차를 줄이도록 모델 내부의 숫자를 조정하는 것입니다.
개념과 패턴 사이
여기서 사람과의 차이가 드러납니다.
사람은 이미 쌓아온 경험을 바탕으로 비교적 적은 사례만 보고도 새로운 개념을 익히곤 합니다. 처음 보는 품종의 고양이를 알아볼 수 있는 것도 그동안 형성한 개념과 경험을 활용하기 때문이겠죠. AI도 학습한 특징을 새로운 이미지에 적용할 수 있습니다. 다만 학습 과정에서 충분히 접하지 못한 환경이나 예상하지 못한 변화 앞에서는 잘못된 판단을 내리기도 합니다. 반대로 사전학습된 모델은 적은 양의 새로운 데이터만으로도 좋은 성능을 보일 수 있습니다.
결국 사람과 AI 모두 경험에서 무언가를 배우지만, 그 경험을 쌓고 활용하는 방식에는 차이가 있습니다.
사람의 선호를 한 번 더 학습한다는 것
많은 대화형 언어 모델은 사전학습 이후 사람의 선호를 반영하는 추가 학습 과정을 거칩니다. 사람이 AI의 여러 답변을 비교하고, 어떤 답변이 더 좋은지 평가하는 겁니다. 이 정보를 활용해 모델이 사람의 의도와 선호에 더 잘 맞는 답변을 생성하도록 조정할 수 있습니다.
대표적인 방법이 인간 피드백 기반 강화학습(RLHF, Reinforcement Learning from Human Feedback)입니다. 다만 사람의 선호를 반영하는 방법이 모두 RLHF인 것은 아닙니다.
이런 과정을 거친 AI의 답변은 사람의 기대에 더 잘 맞을 수 있습니다. 대화하다 보면 뭔가를 진짜 이해하는 것처럼 보이기도 하고요.
학습의 목표와 방법은 달라질 수 있지만, 모델의 파라미터를 조정해 행동을 변화시킨다는 점에서는 공통점이 있습니다. 사람이 선호하는 답변을 더 잘 생성하도록 모델을 다듬는 과정인 셈입니다.
그래서, 배운걸까요?
AI는 분명 학습을 통해 달라집니다. 수많은 파라미터가 조정되고, 이전에는 구별하지 못했던 것을 구별하거나 새로운 질문에 더 적절하게 답할 수 있게 됩니다. 하지만 그걸 사람이 무언가를 배웠을 때와 같은 의미로 볼 수 있을지는 저도 아직 확신하지 못합니다. 우리가 둘 다 '학습'이라고 부르고 있다는 사실이 조금 묘하게 느껴집니다.